Ciclo de vida da máquina virtual
Uma máquina virtual no vStack Center existe em três lugares ao mesmo tempo. O banco de dados do cluster armazena a configuração de referência dela: nome, quantidade de vCPUs, tamanho da RAM, perfil de SO e listas de discos e portas de rede. Os datasets ZFS dos discos ficam em um pool de armazenamento. Um nó executa o processo do hipervisor construído a partir dessa configuração. O vStack Center é o plano de controle: ele mantém a configuração de referência, enquanto os agentes nos nós executam os comandos.
Essa separação define a principal característica do subsistema: quase toda operação de VM
altera primeiro o registro do cluster e depois o estado no nó. Por isso, uma VM tem dois
status. admin_status é o estado desejado, definido pelo vStack Center a pedido do
operador. oper_status é o estado real, informado pelos agentes, junto com
oper_status_ts, o horário da última atualização. Enquanto um comando está a caminho do
nó, os status diferem, o que é normal. Uma divergência que persiste por minutos
é um sinal para investigar.
Para impedir que duas operações sobrescrevam a mesma VM ao mesmo tempo, o vStack Center define a
flag locked. Iniciar, parar, adicionar um disco e o ballooning bloqueiam a VM durante a
operação e liberam o bloqueio no handler de resposta do agente. Enquanto
a flag está definida, as chamadas concorrentes são rejeitadas com "VM is locked"; apenas uma solicitação
consegue obter a VM, porque a verificação e a atualização da flag são uma única ação atômica.
A partir da versão 3.1.0, um bloqueio travado normalmente não precisa ser liberado manualmente. Uma
falha de comunicação com o message broker libera o bloqueio automaticamente antes que
o operador veja o erro. O estado transitório de uma VM não dura mais que o timeout dele
(consulte a tabela abaixo). Quando o timeout expira, a VM passa para o estado de
falha correspondente, e o motivo é registrado no log do serviço e no histórico de estados da VM.
O vm-unlock manual continua disponível para os casos que nenhum dos mecanismos resolve,
e apenas o papel Cluster master pode usá-lo.
O segundo atributo usado em todo o subsistema é a versão de configuração, hw_version.
VMs com a versão de configuração três restam de instalações mais antigas: a família de métodos v4 não
as gerencia e rejeita as solicitações com um código de erro próprio. Tudo o que está descrito
nesta seção se aplica a hw_version = 4; VMs v3 permitem apenas leitura e exclusão.
O terceiro atributo determina onde uma VM pode ser executada. O campo nvme indica o
modo de conexão do disco: true significa NVMe, e false significa virtio-blk. No modo NVMe,
os discos ficam acessíveis ao nó pela rede, então uma VM pode iniciar em qualquer nó online
do cluster, e o vStack Center pode selecionar sozinho o nó menos carregado. Com virtio-blk,
o disco fica visível apenas para o nó que hospeda o pool, então a VM só pode iniciar nele.
VMs Windows trazidas da configuração de disco antiga normalmente têm nvme = false.
O vStack Center não mantém solicitações abertas em operações longas. Ele coloca o comando na fila e devolve o controle imediatamente; o controlador de armazenamento e o agente do nó então fazem o trabalho. Isso define como ler a interface: um comando aceito ainda não foi concluído. A conclusão é confirmada pelo status da VM e por uma entrada no histórico de eventos no cartão da VM.
Estados da VM
O estado da VM aparece na coluna State da lista de VMs e no cartão da VM. A
lista de VMs é aberta na guia Virtual Machines do VDC e contém as colunas ID, Name, IP,
OS, State e Health.
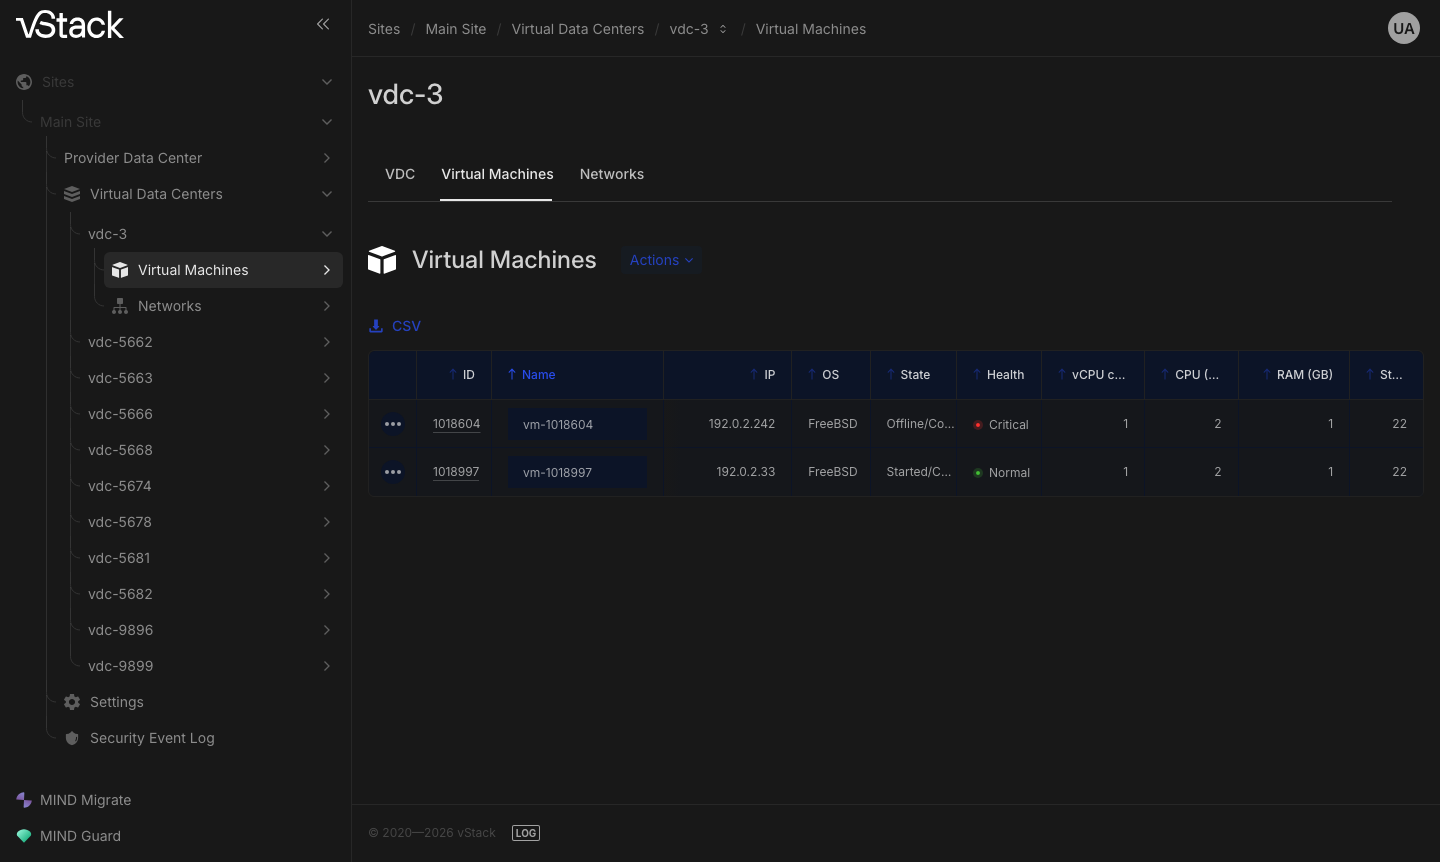
Os valores de admin_status usados para validar operações de energia:
admin_status | Estado | Operações disponíveis |
|---|---|---|
1 | Parada | Iniciar, reverter para um snapshot, clonar, migrar, adicionar e remover discos e portas de rede |
10 | Criada, nunca iniciada | Iniciar, migrar |
3 | Em execução | Parar, reiniciar, suspender, alterar limites, ballooning, console |
11 | Suspensa | Retomar |
9 | Em exclusão | Nenhuma: há uma operação em andamento |
Estados transitórios e seus timeouts
Um estado transitório indica uma operação em andamento, e não um estado final. A partir da versão 3.1.0, cada um tem seu próprio timeout: se o agente não responder dentro desse tempo, a VM passa para o estado de falha correspondente e é desbloqueada, de modo que a operação pode ser repetida e a exclusão deixa de ser rejeitada por a VM estar bloqueada. Os timeouts refletem a natureza de cada operação, em vez de usar um valor comum.
| Estado transitório | Timeout | Estado após o timeout |
|---|---|---|
| Iniciando | 15 minutos | Falha ao iniciar |
| Parando | 30 minutos | Falha ao parar |
| Suspendendo | 30 minutos | Falha ao suspender |
| Retomando | 30 minutos | Falha ao retomar |
| Em criação | 1 hora | Falha na criação |
| Em exclusão | 1 hora | Falha na exclusão |
| Em migração | 6 horas | Falha na migração |
| Em restauração | 6 horas | Falha na restauração |
Há dois esclarecimentos. Uma VM criada com sucesso que nunca foi iniciada não está sujeita a essa regra: ela pode legitimamente permanecer no estado de criação até o primeiro evento do nó ou ciclo de inventário. Além disso, quando um agente trava, a VM sai do estado transitório quando o timeout expira, e não imediatamente; se o agente responder mais tarde, o estado da VM é corrigido para refletir o estado real.
Outro comando de início para uma VM que já está em execução retorna "Unable to start VM having admin_status==N already". Uma VM suspensa pode ser parada com o comando de parada normal; para iniciá-la, primeiro retome-a da suspensão.
Versão de configuração e modo de disco
| Atributo | Valor | Efeito |
|---|---|---|
hw_version | 4 | Conjunto completo de operações |
hw_version | 3 | Os métodos v4 rejeitam a solicitação: "VM with hardware version == 3 can't be managed via v4 method"; snapshots e reversão ficam indisponíveis |
nvme | true | Início em qualquer nó online; se nenhum nó for selecionado explicitamente, o vStack Center seleciona o nó menos carregado |
nvme | false | Início apenas no nó do pool; uma tentativa de iniciar em outro nó retorna "virtio-blk VM: start only on the pool node" |
create_completed | 0 para Windows com nvme = true | O início remoto é proibido até que a configuração inicial seja concluída: "Windows: finish setup on the pool node before remote start" |
O modo de disco de uma VM existente não pode ser trocado em funcionamento: alterar a configuração de disco depois de instalar o Windows impede o sistema convidado de inicializar. Por isso, as VMs trazidas da configuração antiga permanecem no modo virtio-blk e ficam vinculadas ao nó do pool.
Operações imediatas e adiadas
O vStack Center executa algumas operações por conta própria, imediatamente: exibir a lista de VMs e o cartão da VM, retornar um endereço de console e ler dados de referência. Outras operações exigem o agente do nó ou o controlador de armazenamento: iniciar, parar, criar e expandir um disco, snapshots e migração. Esses comandos são registrados primeiro e executados depois.
Na prática, funciona assim. O comando é aceito, a VM é marcada como
bloqueada, e os status dela divergem. Após alguns segundos — ou minutos, no caso de migração —
oper_status alcança admin_status, o bloqueio é liberado, e o histórico de
eventos da VM ganha uma entrada com a ação, o status e a duração. Uma entrada de erro
significa que a operação não foi concluída; ela pode ser repetida depois que o bloqueio for liberado.
Em algumas operações, o comportamento depende do estado da VM. Definir um limite de disco ou de porta de rede em uma VM parada altera apenas o registro do cluster e tem efeito imediato; em uma VM em execução, o comando é enviado ao nó. O sucesso parcial é um caso à parte: o limite é salvo na configuração, mas o agente não o aplica ("Ratelimit has been set (DB), but agent didn't apply it"). O valor passa a valer na próxima vez que a VM iniciar.
Limites de capacidade
O início de uma VM envolve duas verificações independentes. Primeiro, o vStack Center verifica as cotas do VDC (data center virtual) de vCPU, RAM e armazenamento. Em seguida, verifica o overcommit de RAM no nível do cluster.
| Código de erro | Mensagem | Causa |
|---|---|---|
-415 | vDC CPU cores quota depleted | A cota de núcleos do VDC está esgotada |
-414 | vDC RAM quota depleted | A cota de RAM do VDC está esgotada |
-413 | vDC storage quota depleted | A cota de armazenamento do VDC está esgotada |
-440 | Cluster RAM has been depleted | O cluster não tem RAM suficiente, considerando o overcommit |
-458 | No available online nodes for VM placement | Nenhum nó online está disponível para o posicionamento automático |
-461 | VM is running on another cluster node | Um nó informou que a VM está em execução em um nó diferente daquele visado pelo comando de início (a partir da versão 3.2.0) |
A diferença entre iniciar e reiniciar é sutil, mas importa para o planejamento
de capacidade. Com vms-start, os recursos da VM são somados ao consumo atual
porque ainda não estão em uso. Com vms-restart, a VM já está contabilizada,
então os recursos dela não são somados novamente, e a verificação de overcommit não subtrai a RAM
dela da RAM livre.
Mapa de operações
| Tarefa | Métodos |
|---|---|
| Criar ou excluir uma VM, movê-la entre VDCs | vms-create, vms-remove, vm-change-vdc |
| Energia, suspensão, console, desbloqueio | vms-start, vms-stop, vms-restart, vms-suspend, vms-resume, vms-suspend-pool, vms-resume-pool, vm-console, vm-unlock |
| Discos, memória, CPU | vms-add-disk, vms-disk-resize, vm-remove-disk, vm-disk-set-label, vm-ratelimit-disk, vm-set, vms-balloon, vms-cpu-priority, vms-vcpu-class |
| Interfaces de rede | vms-add-nic, vm-remove-nic, vm-ratelimit-nic |
| Snapshots e reversão | vms-snapshot, vm-snapshot-list, snapshot-list, vms-snapshot-remove, vms-rollback |
| Migração, clonagem, restauração a partir da área de importação | vm-migrate, vm-migrate-status, vm-migration, vms-clone, vm-import-area-list, vm-import-area-process |
| Inventário, métricas, validação de configuração | vm-list, vm-get, vm-history, vm-perfdata, vm-check-configuration, vm-inventory |
Veja também
- Como criar, excluir e mover uma máquina virtual
- Como gerenciar a energia da VM e conectar-se ao console
- Como gerenciar os discos e os recursos de computação da VM
- Como conectar uma VM a uma rede
- Como criar snapshots de VM e reverter para eles
- Como migrar e clonar uma VM
- Inventário, métricas e validação de configuração de VMs — referência de campos de resposta e métodos de referência
Métodos da API
As operações da API desta página estão listadas na tabela "Mapa de operações" acima — consulte a referência da API.