Como gerenciar a energia da VM e conectar-se ao console
No vStack Center, um comando de energia é uma transação curta, e não um simples liga/desliga. O vStack Center verifica as permissões, o estado da VM, as cotas do VDC (data center virtual) e o overcommit do cluster, seleciona um nó, bloqueia a VM, registra o estado desejado e envia o comando ao agente do nó. O bloqueio é liberado quando o agente responde; até lá, as demais operações nessa VM são rejeitadas.
A partir da versão 3.2.0, outra etapa precede a inicialização: o vStack Center pergunta aos nós se a VM já está em execução em algum lugar. Antes, a decisão se baseava apenas no registro do banco de dados do Center. Se esse registro não correspondesse à realidade, o comando era enviado a um segundo nó, e dois hipervisores gravavam no mesmo disco. As regras da consulta são as seguintes:
- A VM está em execução em outro nó: a inicialização é rejeitada com o código
-461. O número do nó é omitido da mensagem de propósito: um locatário não deve conhecer a topologia do cluster por uma mensagem de erro. O nó é registrado no log de serviço. - A VM está em execução no nó de destino do comando de inicialização: é retornado o
erro habitual
-457"already running". - Os nós permanecem em silêncio, retornam uma resposta inesperada ou simplesmente não respondem: a inicialização não é bloqueada. Um nó indisponível não deve impedir que as VMs sejam iniciadas após uma falha, que é exatamente o cenário para o qual a inicialização é necessária.
Todos os nós são consultados simultaneamente dentro de um limite de tempo comum (10 segundos por padrão), o que atrasa a resposta à inicialização por esse tempo. A recuperação automática de VMs segue a mesma regra.
A seleção do nó é a parte mais importante da inicialização. No modo de disco NVMe
(nvme = true), os discos são acessíveis pela rede, portanto a VM pode ser iniciada
em qualquer nó online: se nenhum nó for selecionado explicitamente, o próprio vStack
Center seleciona o nó menos carregado. Com virtio-blk (nvme = false), o disco é
visível apenas para o nó que hospeda o pool, e a inicialização em qualquer outro nó
é rejeitada.
O console funciona de outra forma: o vStack Center não consulta o nó. Ele lê as credenciais do cluster, retorna o endereço do console com um token de uso único e, antes disso, redefine as conexões anteriores a esse endereço e porta. Uma nova sessão desconecta a anterior.
As operações com a VM são acessadas pelo botão Actions, disponível tanto no cartão da VM quanto na lista de VMs.
Como iniciar uma VM
Acesso: o Cluster master pode iniciar qualquer VM do cluster; um usuário comum pode
iniciar VMs em um VDC no qual tenha um papel com role_id ≤ 3.
-
Verifique se a VM está parada ou foi recém-criada: o estado dela aparece na coluna State da lista de VMs e no cartão da VM.
-
Abra o cartão da VM (ou encontre-a na lista), clique em Actions e selecione o comando de inicialização.
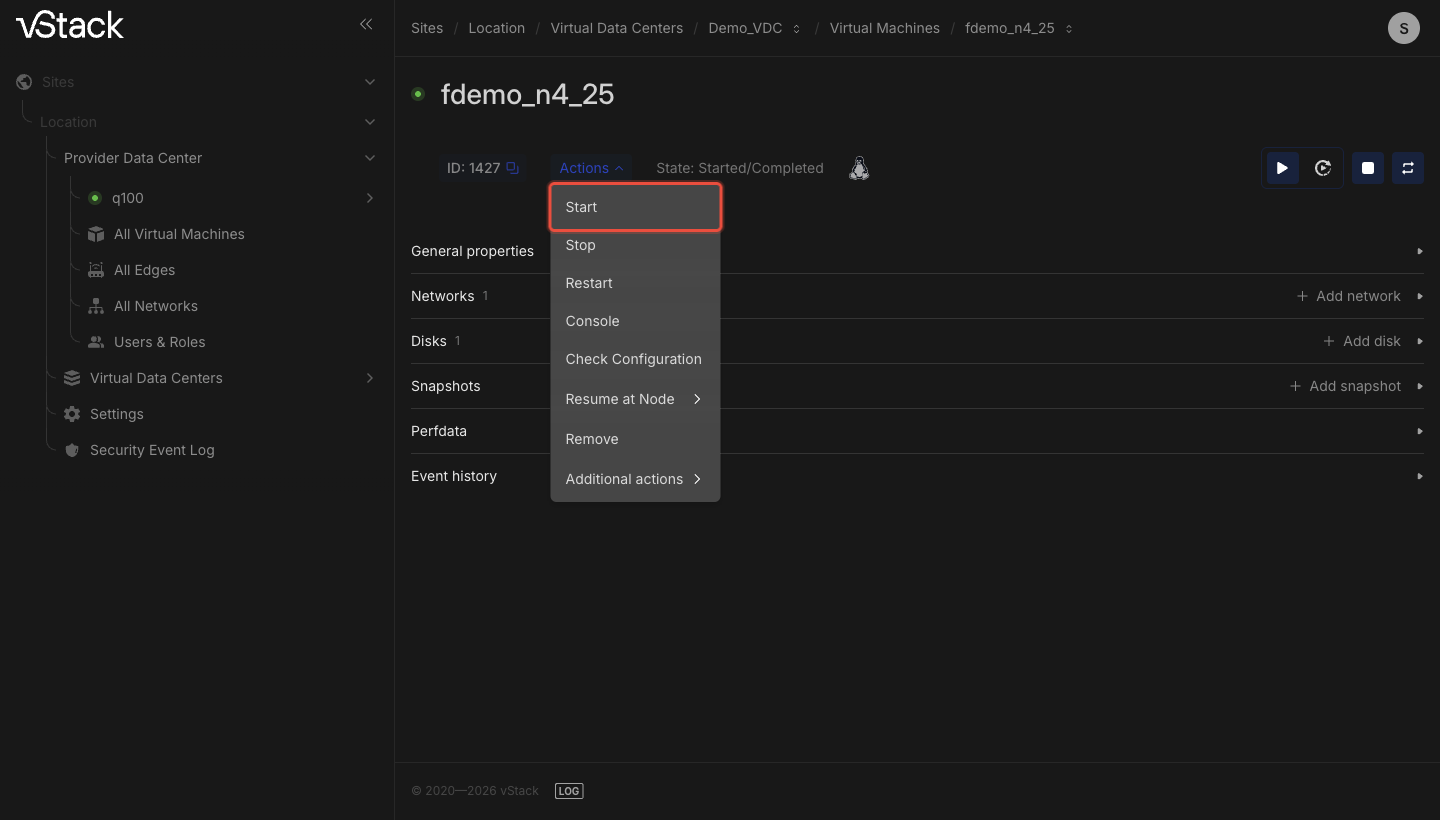
-
Selecione um nó ou mantenha a seleção automática habilitada. Você também pode definir o tempo limite do desligamento forçado (0–999 segundos) e desabilitar o desligamento por ACPI; o número do nó vai de 1 até a quantidade de nós do cluster.
-
Aguarde até que o estado da VM mude para "running". O nó em que ela foi iniciada aparece no cartão, quer você o tenha selecionado explicitamente, quer automaticamente.
Se a inicialização falhar
| Falha | Motivo | Solução |
|---|---|---|
-460 virtio-blk VM: start only on the pool node | A VM tem nvme = false, e o nó selecionado não é o nó do pool | Inicie no nó do pool: mantenha a seleção automática habilitada |
-459 Windows: finish setup on the pool node before remote start | Windows com nvme = true; a configuração inicial do guest não foi concluída | Conclua a configuração do guest no nó do pool e depois inicie remotamente |
-458 No available online nodes for VM placement | Não há nenhum nó online disponível para o posicionamento automático | Aguarde o retorno dos nós ou selecione um nó manualmente |
-455 VM has suspended status | A VM está suspensa | Retome a VM em vez de iniciá-la |
-457 Unable to start VM having admin_status==N already | A VM já está em execução, inclusive segundo o nó de destino do comando de inicialização | Verifique o estado da VM no cartão |
-461 VM is running on another cluster node; unable to start | Um nó informou que a VM está em execução em um nó diferente do nó de destino do comando de inicialização. A partir da versão 3.2.0 | Descubra onde a VM está em execução e pare-a lá; o nó é indicado no log de serviço |
-409 VM is locked | Outra operação está em andamento | Aguarde a conclusão; o papel Cluster master pode liberar um bloqueio travado |
-413, -414, -415 | A cota de armazenamento, RAM ou núcleos do VDC está esgotada | Aumente a cota ou libere recursos |
-440 Cluster RAM has been depleted | O cluster não tem RAM suficiente, considerando o overcommit | Libere memória do cluster |
-452 Remote disk attach error | Não foi possível conectar os discos NVMe-oF durante a inicialização remota | Inicie no nó do pool e verifique o estado do nó |
-442, -443 | Foi selecionado um nó inexistente | Verifique a lista de nós do cluster |
Como parar e reiniciar uma VM
A parada espelha a inicialização, mas sem verificação de cotas: a VM já está contabilizada. O vStack Center identifica o nó em que a VM está em execução, bloqueia a VM e envia o comando de parada. O acesso é o mesmo, por Actions no cartão da VM ou na lista.
O comando de parada aceita uma VM suspensa da mesma forma que aceita uma VM em execução.
A reinicialização segue a lógica da inicialização, com duas diferenças: as cotas são verificadas sem somar os recursos da VM, e o overcommit é verificado sem subtrair a RAM da VM da RAM livre. É usado o nó atual.
As duas operações têm um tempo limite de desligamento forçado e a opção de desabilitar o ACPI. Se o guest não responder ao ACPI, o desligamento forçado após o tempo limite é o caminho normal; desabilitar o ACPI ignora totalmente a tentativa de desligamento normal.
O que acontece com uma VM após uma falha
Além do estado atual, o vStack Center armazena uma intenção para cada VM: se ela deve estar em execução. A inicialização define a intenção "deve estar em execução"; a parada por um administrador a remove. A recuperação automática após uma falha traz de volta apenas as VMs com a intenção "deve estar em execução".
A partir da versão 3.2.0, o Center distingue o motivo pelo qual uma VM foi desligada e remove a intenção em apenas um caso: quando o guest é desligado normalmente. Após uma falha do hipervisor, uma reinicialização solicitada pelo guest, o desligamento de um nó ou um desligamento forçado após o tempo limite, a intenção é preservada e a VM é iniciada novamente. Antes, qualquer um desses eventos marcava a VM como parada por um administrador, e ela permanecia desligada após uma falha.
O agente do nó informa o motivo do desligamento. Um agente lançado antes do vStack OS 3.2.0 não envia essa informação. Nesses nós, o comportamento anterior permanece: após uma falha, a VM é considerada parada até que o agente seja atualizado.
A recuperação é disparada por um evento, e não por um temporizador:
- A VM falha enquanto o pool está operacional: a recuperação começa imediatamente.
- O pool ainda não está pronto: a VM aguarda o armazenamento ficar disponível e é iniciada junto com as demais VMs do pool.
- A primeira tentativa de inicialização falha por causa da falha de um nó: o Center tenta novamente, no máximo três vezes. Se essas tentativas também falharem, as novas tentativas param, mas a intenção permanece, e a próxima passagem disparada por qualquer outro motivo tentará iniciar a VM.
- Os recursos são insuficientes para a inicialização: a VM mantém a intenção "deve estar em execução", o motivo é registrado no log de serviço, e a inicialização não é repetida por temporizador.
A recuperação não causa uma inicialização duplicada: ela ignora uma VM cuja inicialização já está em andamento ou que está em execução em qualquer nó. Aplica-se a mesma regra de consulta aos nós da inicialização manual.
Como suspender e retomar uma VM
A suspensão salva o estado da memória e exige que a suspensão esteja habilitada nas
configurações do cluster. Acesso: o Cluster master tem acesso total; os demais usuários
precisam de role_id ≤ 2. O comando é acessado por Actions; a VM passa para o
estado "suspended".
Ao retomar, especifique explicitamente o nó de destino. As restrições de posicionamento
são as mesmas da inicialização: com nvme = false, a VM só pode ser retomada no nó do
pool (-15152), e o Windows com nvme = true não pode ser retomado remotamente até que
a configuração inicial seja concluída (-15151). Se a suspensão estiver desabilitada
nas configurações do cluster, a suspensão retorna -15005, e a retomada retorna
-15105.
Operações em massa no pool
Para a manutenção de nós, há um par de operações no nível do pool: suspender todas as VMs do pool e retomá-las. Apenas o papel Cluster master pode usá-las, a partir do cartão do pool, que também tem um botão Actions. Você também pode especificar se as VMs devem ser restauradas em caso de erro.
O comando é enviado diretamente ao nó que atende o pool. Falhas: -403 significa que a
operação foi solicitada por um papel diferente de Cluster master (o mesmo código para
suspender e retomar), -15203 e -15303 significam um nome de pool inválido, e
-15205 e -15305 significam que a suspensão está desabilitada.
Como abrir o console
O console é aberto por Actions no cartão da VM, imediatamente, sem contatar o nó. Acesso: o Cluster master pode acessar qualquer VM; um usuário comum pode acessar as VMs dos seus VDCs.
Há dois tipos de console: gráfico (VNC), o padrão, e texto. Cada tipo tem sua própria porta. Se a VM estiver em execução em um nó diferente do nó do pool, o endereço do console aponta para o endereço público do nó em que a VM está em execução.
Tenha em mente o seguinte:
- Na prática, o link é de uso único: cada vez que o console é aberto, as conexões anteriores ao mesmo endereço e porta são redefinidas. Duas sessões de console simultâneas com uma VM não conseguem permanecer conectadas.
- O erro
-3103significa que a VM não foi encontrada no seu escopo de visibilidade. - O vStack Center não verifica se a VM está em execução: o endereço é retornado a partir das credenciais do cluster. Se não for possível estabelecer a conexão, verifique os estados da VM e do nó.
Como liberar um bloqueio
O sinalizador de bloqueio é removido automaticamente quando o agente responde. Se o agente não responder e o sinalizador permanecer definido, apenas o papel Cluster master poderá removê-lo.
O erro -25903, "VM unlock method available for Cluster master only", significa que
outro papel solicitou o desbloqueio. Libere o bloqueio somente depois de confirmar que
a operação anterior realmente terminou; caso contrário, uma resposta tardia do agente
vai se sobrepor ao novo comando.
Veja também
- Ciclo de vida da máquina virtual — o que significam os status e por que uma VM tem dois estados
- O console VNC não abre — solução de problemas quando o console não abre
Métodos da API
As operações da API desta página são vms-start, vms-stop, vms-restart,
vms-suspend, vms-resume, vms-suspend-pool, vms-resume-pool, vm-console
e vm-unlock — consulte a referência da API.