Ciclo de vida de una máquina virtual
Una máquina virtual en vStack Center existe en tres lugares a la vez. La base de datos del clúster almacena su configuración de referencia: nombre, número de vCPU, tamaño de RAM, perfil de SO y listas de discos y puertos de red. Los datasets ZFS de los discos residen en un pool de almacenamiento. Un nodo ejecuta el proceso del hipervisor construido a partir de esta configuración. vStack Center es el plano de control: mantiene la configuración de referencia, mientras que los agentes de los nodos ejecutan los comandos.
Esta separación define la característica principal del subsistema: casi todas las operaciones con una VM
cambian primero el registro del clúster y después el estado en el nodo. Por ello, una VM tiene dos
estados. admin_status es el estado deseado, que vStack Center establece a petición del
operador. oper_status es el estado real, que notifican los agentes, junto con
oper_status_ts, la hora de la última actualización. Mientras un comando está en camino hacia el
nodo, los estados difieren, lo cual es normal. Una discrepancia que persiste durante minutos
es una señal para investigar.
Para evitar que dos operaciones sobrescriban la misma VM a la vez, vStack Center establece el
indicador locked. El arranque, la detención, la adición de un disco y el ballooning bloquean la VM durante
la operación y liberan el bloqueo en el manejador de la respuesta del agente. Mientras
el indicador está establecido, las llamadas concurrentes se rechazan con "VM is locked"; solo una solicitud
puede tomar la VM, porque la comprobación y la actualización del indicador son una única acción atómica.
A partir de la versión 3.1.0, normalmente no es necesario liberar manualmente un bloqueo atascado. Un
fallo de comunicación con el intermediario de mensajes (message broker) libera automáticamente el bloqueo antes
de que el operador vea el error. El estado de transición de una VM no dura más que su tiempo de espera
(consulte la tabla siguiente). Cuando vence el tiempo de espera, la VM pasa al estado de fallo
correspondiente, y el motivo se registra en el registro del servicio y en el historial de estados de la VM.
El comando manual vm-unlock sigue disponible para los casos que ninguno de los dos mecanismos resuelve,
y solo el rol Cluster master puede usarlo.
El segundo atributo que se usa en todo el subsistema es la versión de configuración, hw_version.
Las VM con la versión de configuración tres proceden de instalaciones antiguas: la familia de métodos v4 no
las gestiona y rechaza las solicitudes con un código de error propio. Todo lo que se describe
en esta sección se aplica a hw_version = 4; las VM v3 solo admiten lectura y eliminación.
El tercer atributo determina dónde puede ejecutarse una VM. El campo nvme indica el
modo de conexión de los discos: true significa NVMe, y false significa virtio-blk. En el modo NVMe,
los discos son accesibles para el nodo a través de la red, por lo que una VM puede arrancar en cualquier nodo
en línea del clúster, y vStack Center puede seleccionar por sí mismo el nodo menos cargado. Con virtio-blk,
el disco solo es visible para el nodo que aloja el pool, por lo que la VM solo puede arrancar allí.
Las VM Windows heredadas de la configuración de discos antigua suelen tener nvme = false.
vStack Center no mantiene abiertas las solicitudes de operaciones largas. Pone el comando en cola y devuelve el control de inmediato; después, el controlador de almacenamiento y el agente del nodo realizan el trabajo. Esto determina cómo interpretar la interfaz: un comando aceptado todavía no se ha completado. La finalización se confirma mediante el estado de la VM y una entrada en el historial de eventos de la ficha de la VM.
Estados de la VM
El estado de la VM aparece en la columna State de la lista de VM y en la ficha de la VM. La
lista de VM se abre en la pestaña Virtual Machines del VDC y contiene las columnas ID, Name, IP,
OS, State y Health.
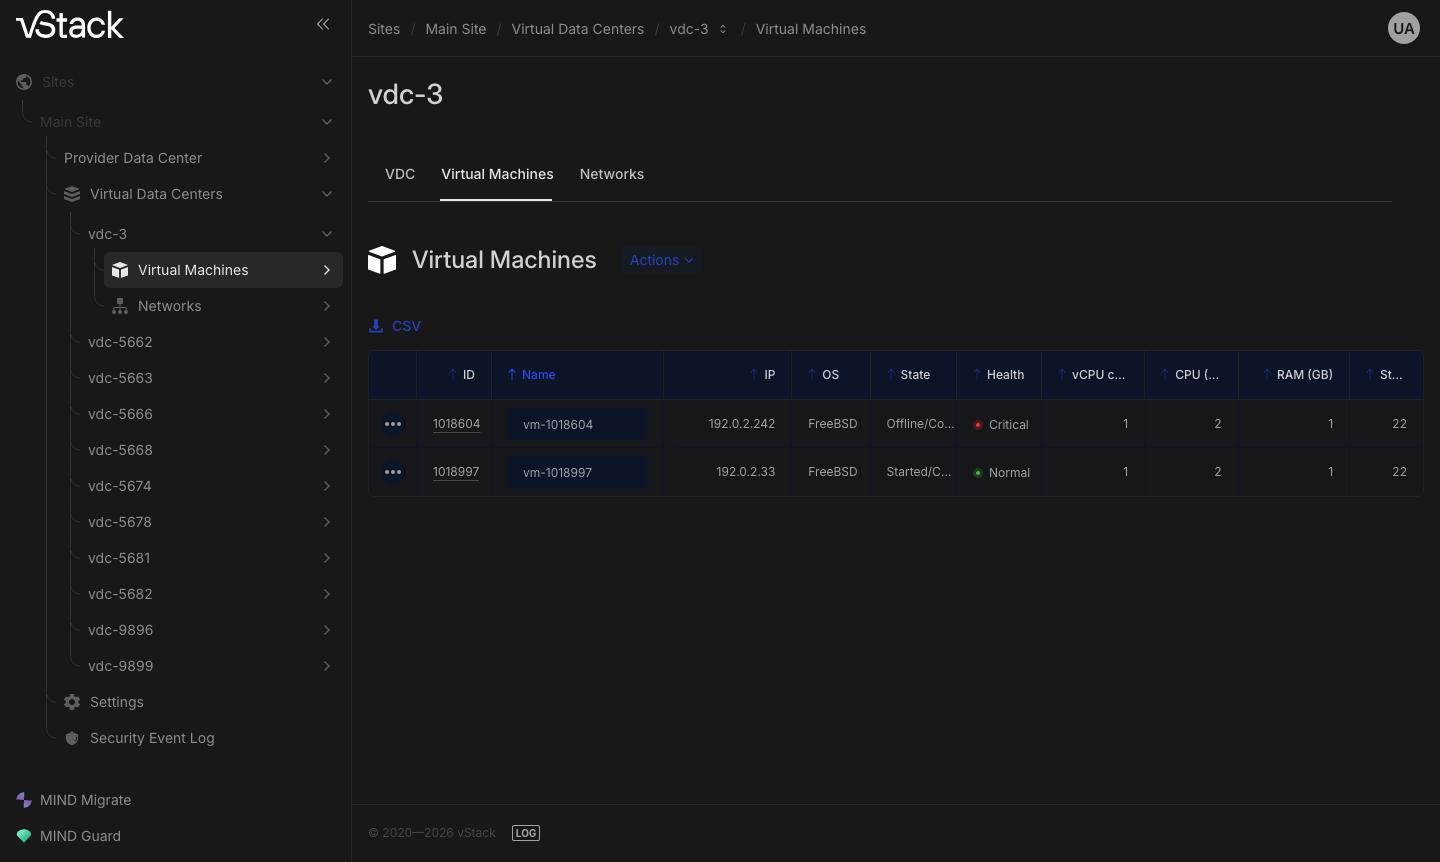
Los valores de admin_status que se usan para validar las operaciones de encendido:
admin_status | Estado | Operaciones disponibles |
|---|---|---|
1 | Stopped | Arrancar, revertir a una instantánea, clonar, migrar, añadir y quitar discos y puertos de red |
10 | Created (creada, nunca iniciada) | Arrancar, migrar |
3 | Running | Detener, reiniciar, suspender, cambiar límites, ballooning, consola |
11 | Suspended | Reanudar |
9 | Being deleted (en eliminación) | Ninguna: hay una operación en curso |
Estados de transición y sus tiempos de espera
Un estado de transición indica una operación en curso, y no un estado final. A partir de la versión 3.1.0, cada uno tiene su propio tiempo de espera: si el agente no responde dentro de ese plazo, la VM pasa al estado de fallo correspondiente y se desbloquea, de modo que la operación puede reintentarse y la eliminación deja de rechazarse por estar la VM bloqueada. Los tiempos de espera reflejan la naturaleza de cada operación en lugar de usar un único valor común.
| Estado de transición | Tiempo de espera | Estado tras el tiempo de espera |
|---|---|---|
| Starting (arrancando) | 15 minutos | Start failed (fallo de arranque) |
| Stopping (deteniéndose) | 30 minutos | Stop failed (fallo de detención) |
| Suspending (suspendiéndose) | 30 minutos | Suspend failed (fallo de suspensión) |
| Resuming (reanudándose) | 30 minutos | Resume failed (fallo de reanudación) |
| Being created (en creación) | 1 hora | Creation failed (fallo de creación) |
| Being deleted (en eliminación) | 1 hora | Deletion failed (fallo de eliminación) |
| Being migrated (en migración) | 6 horas | Migration failed (fallo de migración) |
| Being restored (en restauración) | 6 horas | Restore failed (fallo de restauración) |
Se aplican dos aclaraciones. Una VM creada correctamente que nunca se ha iniciado no está sujeta a esta regla: puede permanecer legítimamente en el estado de creación hasta el primer evento del nodo o el primer ciclo de inventario. Además, cuando un agente se bloquea, la VM sale del estado de transición cuando vence el tiempo de espera, y no de inmediato; si el agente responde más tarde, el estado de la VM se corrige para reflejar su estado real.
Un nuevo comando de arranque para una VM que ya está en ejecución devuelve "Unable to start VM having admin_status==N already". Una VM suspendida puede detenerse con el comando de detención normal; para arrancarla, reanúdela primero desde la suspensión.
Versión de configuración y modo de disco
| Atributo | Valor | Efecto |
|---|---|---|
hw_version | 4 | Conjunto completo de operaciones |
hw_version | 3 | Los métodos v4 rechazan la solicitud: "VM with hardware version == 3 can't be managed via v4 method"; las instantáneas y la reversión no están disponibles |
nvme | true | Arranque en cualquier nodo en línea; si no se selecciona explícitamente ningún nodo, vStack Center selecciona el nodo menos cargado |
nvme | false | Arranque solo en el nodo del pool; un intento de arranque en otro nodo devuelve "virtio-blk VM: start only on the pool node" |
create_completed | 0 para Windows con nvme = true | El arranque remoto está prohibido hasta que se complete la configuración inicial: "Windows: finish setup on the pool node before remote start" |
El modo de disco de una VM existente no se puede cambiar sobre la marcha: cambiar la configuración de discos después de instalar Windows impide que el sistema invitado arranque. Por ello, las VM heredadas de la configuración antigua permanecen en el modo virtio-blk y están vinculadas al nodo del pool.
Operaciones inmediatas y diferidas
vStack Center realiza algunas operaciones por sí mismo, de inmediato: mostrar la lista de VM y la ficha de la VM, devolver la dirección de la consola y leer los datos de referencia. Otras operaciones requieren el agente del nodo o el controlador de almacenamiento: arrancar, detener, crear y ampliar un disco, las instantáneas y la migración. Estos comandos se registran primero y se ejecutan después.
En la práctica, funciona así. El comando se acepta, la VM se marca como
bloqueada y sus estados divergen. Al cabo de unos segundos (o minutos, en el caso de la migración),
oper_status alcanza a admin_status, se libera el bloqueo y el historial de eventos de la VM
recibe una entrada con la acción, el estado y la duración. Una entrada de error
significa que la operación no se completó; puede reintentarse una vez liberado el bloqueo.
En algunas operaciones, el comportamiento depende del estado de la VM. Establecer un límite de disco o de puerto de red en una VM detenida solo cambia el registro del clúster y surte efecto de inmediato; en una VM en ejecución, el comando se envía al nodo. El éxito parcial es un caso aparte: el límite se guarda en la configuración, pero el agente no lo aplica ("Ratelimit has been set (DB), but agent didn't apply it"). El valor surte efecto la próxima vez que se arranque la VM.
Límites de capacidad
El arranque de una VM implica dos comprobaciones independientes. En primer lugar, vStack Center comprueba las cuotas del VDC (centro de datos virtual) de vCPU, RAM y almacenamiento. A continuación, comprueba la sobreasignación de RAM a nivel de clúster.
| Código de error | Mensaje | Causa |
|---|---|---|
-415 | vDC CPU cores quota depleted | La cuota de núcleos del VDC está agotada |
-414 | vDC RAM quota depleted | La cuota de RAM del VDC está agotada |
-413 | vDC storage quota depleted | La cuota de almacenamiento del VDC está agotada |
-440 | Cluster RAM has been depleted | El clúster no tiene RAM suficiente, teniendo en cuenta la sobreasignación |
-458 | No available online nodes for VM placement | No hay ningún nodo en línea disponible para la ubicación automática |
-461 | VM is running on another cluster node | Un nodo notificó que la VM se está ejecutando en un nodo distinto del indicado en el comando de arranque (a partir de la versión 3.2.0) |
La diferencia entre arrancar y reiniciar es sutil, pero importa para la planificación
de la capacidad. Con vms-start, los recursos de la VM se suman al consumo actual
porque todavía no están en uso. Con vms-restart, la VM ya está contabilizada,
por lo que sus recursos no se suman de nuevo, y la comprobación de sobreasignación no resta su
RAM de la RAM libre.
Mapa de operaciones
| Tarea | Métodos |
|---|---|
| Crear o eliminar una VM, moverla entre VDC | vms-create, vms-remove, vm-change-vdc |
| Encendido, suspensión, consola, desbloqueo | vms-start, vms-stop, vms-restart, vms-suspend, vms-resume, vms-suspend-pool, vms-resume-pool, vm-console, vm-unlock |
| Discos, memoria, CPU | vms-add-disk, vms-disk-resize, vm-remove-disk, vm-disk-set-label, vm-ratelimit-disk, vm-set, vms-balloon, vms-cpu-priority, vms-vcpu-class |
| Interfaces de red | vms-add-nic, vm-remove-nic, vm-ratelimit-nic |
| Instantáneas y reversión | vms-snapshot, vm-snapshot-list, snapshot-list, vms-snapshot-remove, vms-rollback |
| Migración, clonación, restauración desde el área de importación | vm-migrate, vm-migrate-status, vm-migration, vms-clone, vm-import-area-list, vm-import-area-process |
| Inventario, métricas, validación de la configuración | vm-list, vm-get, vm-history, vm-perfdata, vm-check-configuration, vm-inventory |
Véase también
- Cómo crear, eliminar y mover una máquina virtual
- Cómo gestionar el encendido de una VM y conectarse a la consola
- Cómo gestionar los discos y los recursos de cómputo de una VM
- Cómo conectar una VM a una red
- Cómo crear instantáneas de una VM y revertir a ellas
- Cómo migrar y clonar una VM
- Inventario, métricas y validación de la configuración de las VM: referencia de los campos de respuesta y métodos de consulta
Métodos de la API
Las operaciones de la API de esta página se enumeran en la tabla "Mapa de operaciones" anterior; consulte la referencia de la API.