Cómo administrar la alimentación de una VM y conectarse a la consola
En vStack Center, un comando de alimentación es una transacción breve y no un simple interruptor. vStack Center comprueba los permisos, el estado de la VM, las cuotas del VDC (centro de datos virtual) y la sobreasignación (overcommit) del clúster, selecciona un nodo, bloquea la VM, registra el estado deseado y envía el comando al agente del nodo. El bloqueo se libera cuando el agente responde; hasta entonces, se rechazan las demás operaciones sobre esta VM.
A partir de la versión 3.2.0, el inicio va precedido de otro paso: vStack Center pregunta a los nodos si la VM ya se está ejecutando en alguno de ellos. Anteriormente, la decisión se basaba solo en el registro de la base de datos de Center. Si ese registro no coincidía con la realidad, el comando se enviaba a un segundo nodo y dos hipervisores escribían en el mismo disco. Las reglas de consulta son las siguientes:
- La VM se está ejecutando en otro nodo: el inicio se rechaza con el código
-461. El número de nodo se omite deliberadamente del mensaje: un inquilino no debe conocer la topología del clúster a partir de un mensaje de error. El nodo se registra en el registro de servicio. - La VM se está ejecutando en el nodo al que se dirige el comando de inicio: se devuelve el error habitual
-457"already running". - Los nodos no informan nada, devuelven una respuesta inesperada o no responden en absoluto: el inicio no se bloquea. Un nodo no disponible no debe impedir que las VM se inicien después de un fallo, que es precisamente el escenario para el que se necesita el inicio.
Todos los nodos se consultan simultáneamente dentro de un presupuesto de tiempo común (10 segundos de forma predeterminada), lo que retrasa la respuesta al inicio en ese tiempo. La recuperación automática de las VM sigue la misma regla.
La selección del nodo es la parte más importante del inicio. En el modo de disco NVMe
(nvme = true), los discos son accesibles a través de la red, por lo que una VM puede iniciarse en cualquier
nodo en línea: si no se selecciona explícitamente ningún nodo, vStack Center selecciona por sí mismo el nodo
menos cargado. Con virtio-blk (nvme = false), el disco solo es visible para
el nodo que aloja el pool, y se rechaza el inicio en cualquier otro nodo.
La consola funciona de otra manera: vStack Center no consulta al nodo. Lee las credenciales del clúster, devuelve una dirección de consola con un token de un solo uso y, previamente, restablece las conexiones anteriores a esa dirección y puerto. Una sesión nueva desconecta la anterior.
Las operaciones con VM se realizan mediante el botón Actions, disponible tanto en la tarjeta de la VM como en la lista de VM.
Cómo iniciar una VM
Acceso: Cluster master puede iniciar cualquier VM del clúster; un usuario común puede iniciar
VM en un VDC en el que tenga un rol con role_id ≤ 3.
-
Asegúrese de que la VM esté detenida o recién creada: su estado aparece en la columna State de la lista de VM y en la tarjeta de la VM.
-
Abra la tarjeta de la VM (o búsquela en la lista), haga clic en Actions y seleccione el comando de inicio.
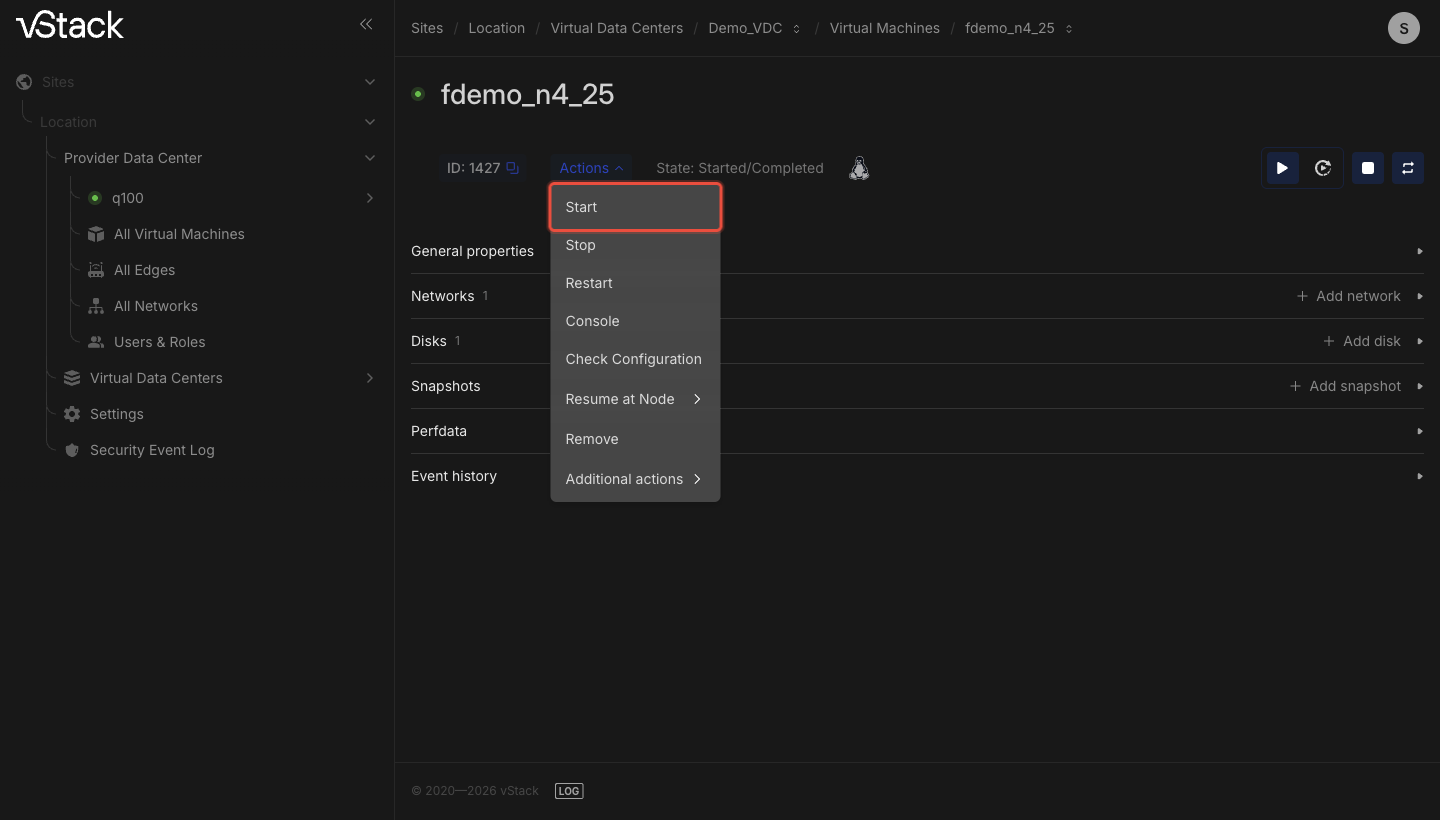
-
Seleccione un nodo o deje habilitada la selección automática. También puede establecer el tiempo de espera para el apagado forzado (0–999 segundos) y deshabilitar el apagado por ACPI; el número de nodo va de 1 al número de nodos del clúster.
-
Espere a que el estado de la VM cambie a "running". El nodo en el que se inició aparece en su tarjeta, tanto si seleccionó el nodo explícitamente como si se seleccionó automáticamente.
Si el inicio falla
| Fallo | Motivo | Solución alternativa |
|---|---|---|
-460 virtio-blk VM: start only on the pool node | La VM tiene nvme = false y el nodo seleccionado no es el nodo del pool | Inicie en el nodo del pool: deje habilitada la selección automática |
-459 Windows: finish setup on the pool node before remote start | Windows con nvme = true; la configuración inicial del invitado no está completa | Complete la configuración del invitado en el nodo del pool y luego inicie de forma remota |
-458 No available online nodes for VM placement | No hay ningún nodo en línea disponible para la colocación automática | Espere a que los nodos vuelvan o seleccione un nodo manualmente |
-455 VM has suspended status | La VM está suspendida | Reanúdela en lugar de iniciarla |
-457 Unable to start VM having admin_status==N already | La VM ya se está ejecutando, incluso según lo informado por el nodo al que se dirige el comando de inicio | Compruebe el estado de la VM en su tarjeta |
-461 VM is running on another cluster node; unable to start | Un nodo informó que la VM se está ejecutando en un nodo distinto del que recibe el comando de inicio. A partir de la versión 3.2.0 | Averigüe dónde se está ejecutando la VM y deténgala allí; el nodo se indica en el registro de servicio |
-409 VM is locked | Hay otra operación en curso | Espere a que termine; el rol Cluster master puede liberar un bloqueo atascado |
-413, -414, -415 | Se agotó la cuota de almacenamiento, RAM o núcleos del VDC | Aumente la cuota o libere recursos |
-440 Cluster RAM has been depleted | El clúster no tiene suficiente RAM, teniendo en cuenta la sobreasignación | Libere memoria del clúster |
-452 Remote disk attach error | No se pudieron conectar los discos NVMe-oF durante el inicio remoto | Inicie en el nodo del pool y compruebe el estado del nodo |
-442, -443 | Se seleccionó un nodo inexistente | Compruebe la lista de nodos del clúster |
Cómo detener y reiniciar una VM
La detención es el reflejo del inicio, pero sin comprobaciones de cuota: la VM ya está contabilizada. vStack Center identifica el nodo en el que se ejecuta la VM, bloquea la VM y envía el comando de detención. Se accede de la misma manera, mediante Actions en la tarjeta de la VM o en la lista.
El comando de detención acepta una VM suspendida igual que una en ejecución.
El reinicio sigue la lógica del inicio con dos diferencias: las cuotas se comprueban sin sumar los recursos de la VM, y la sobreasignación se comprueba sin restar su RAM de la RAM libre. Se utiliza el nodo actual.
Ambas operaciones tienen un tiempo de espera para el apagado forzado y una opción para deshabilitar ACPI. Si el invitado no responde a ACPI, el apagado forzado tras el tiempo de espera es el comportamiento normal; deshabilitar ACPI omite por completo el intento de apagado ordenado.
Qué ocurre con una VM después de un fallo
Además de su estado actual, vStack Center almacena para cada VM una intención: si debe estar en ejecución. El inicio establece la intención "debe estar en ejecución"; la detención por parte de un administrador la borra. La recuperación automática después de un fallo vuelve a poner en marcha solo las VM con la intención "debe estar en ejecución".
A partir de la versión 3.2.0, Center distingue por qué se apagó una VM y borra la intención en un solo caso: cuando el invitado se apaga de forma ordenada. Después de un fallo del hipervisor, de un reinicio solicitado por el invitado, del apagado de un nodo o de un apagado forzado tras el tiempo de espera, la intención se conserva y la VM vuelve a iniciarse. Anteriormente, cualquiera de estos eventos marcaba la VM como detenida por un administrador, y permanecía apagada después de un fallo.
El agente del nodo informa del motivo del apagado. Un agente publicado antes de vStack OS 3.2.0 no lo envía. En esos nodos se mantiene el comportamiento anterior: después de un fallo, la VM se considera detenida hasta que se actualice el agente.
La recuperación se desencadena por un evento, no por un temporizador:
- La VM falla mientras su pool está operativo: la recuperación comienza de inmediato.
- El pool aún no está listo: la VM espera a que el almacenamiento esté disponible y se inicia junto con las demás VM del pool.
- El primer intento de inicio falla debido a un fallo de nodo: Center lo reintenta, no más de tres veces. Si esos intentos también fallan, los reintentos se detienen, pero la intención se mantiene, y la siguiente pasada desencadenada por cualquier otro motivo intentará iniciar la VM.
- Los recursos son insuficientes para el inicio: la VM conserva la intención "debe estar en ejecución", el motivo se registra en el registro de servicio y el inicio no se reintenta por temporizador.
La recuperación no provoca un inicio duplicado: omite una VM cuyo inicio ya está en curso o que se está ejecutando en cualquier nodo. Se aplica la misma regla de consulta a los nodos que en el inicio manual.
Cómo suspender y reanudar una VM
La suspensión guarda el estado de la memoria y requiere que la suspensión esté habilitada en la
configuración del clúster. Acceso: Cluster master tiene acceso completo; los demás usuarios necesitan
role_id ≤ 2. Se accede al comando mediante Actions; la VM pasa al
estado "suspended".
Al reanudar, especifique explícitamente el nodo de destino. Las restricciones de colocación son
las mismas que para el inicio: con nvme = false, la VM solo puede reanudarse en el nodo
del pool (-15152), y Windows con nvme = true no puede reanudarse de forma remota hasta que
se complete la configuración inicial (-15151). Si la suspensión está deshabilitada en la configuración
del clúster, la suspensión devuelve -15005 y la reanudación devuelve -15105.
Operaciones masivas sobre pools
Para el mantenimiento de nodos existen operaciones emparejadas a nivel de pool: suspender todas las VM del pool y reanudarlas. Solo el rol Cluster master puede usarlas, desde la tarjeta del pool, que también tiene un botón Actions. También puede especificar si se deben restaurar las VM en caso de error.
El comando se envía directamente al nodo que atiende el pool. Fallos: -403 significa que
la operación la solicitó un rol distinto de Cluster master (el mismo código
tanto para suspender como para reanudar), -15203 y -15303 significan un nombre de pool no válido,
y -15205 y -15305 significan que la suspensión está deshabilitada.
Cómo abrir la consola
La consola se abre mediante Actions en la tarjeta de la VM, de inmediato, sin contactar con el nodo. Acceso: Cluster master puede acceder a cualquier VM; un usuario común puede acceder a las VM de sus VDC.
Hay dos tipos de consola: gráfica (VNC), la predeterminada, y de texto. Cada tipo tiene su propio puerto. Si la VM se ejecuta en un nodo distinto de su nodo del pool, la dirección de la consola apunta a la dirección pública del nodo en el que se ejecuta la VM.
Tenga en cuenta lo siguiente:
- En la práctica, el enlace es de un solo uso: cada vez que se abre la consola, se restablecen las conexiones anteriores a la misma dirección y puerto. Dos sesiones de consola simultáneas a una misma VM no pueden permanecer conectadas.
- El error
-3103significa que la VM no se encontró dentro de su ámbito de visibilidad. - vStack Center no comprueba si la VM se está ejecutando: la dirección se obtiene de las credenciales del clúster. Si no se puede establecer la conexión, compruebe los estados de la VM y del nodo.
Cómo liberar un bloqueo
El indicador de bloqueo se borra automáticamente cuando el agente responde. Si el agente no responde y el indicador permanece activo, solo el rol Cluster master puede borrarlo.
El error -25903, "VM unlock method available for Cluster master only", significa que otro
rol solicitó el desbloqueo. Libere el bloqueo solo después de confirmar que la
operación anterior ha finalizado realmente; de lo contrario, una respuesta tardía del agente
se superpondrá con el nuevo comando.
Consulte también
- Ciclo de vida de la máquina virtual: qué significan los estados y por qué una VM tiene dos estados
- La consola VNC no se abre: solución de problemas cuando la consola no se abre
Métodos de la API
Las operaciones de la API para esta página son vms-start, vms-stop, vms-restart,
vms-suspend, vms-resume, vms-suspend-pool, vms-resume-pool, vm-console
y vm-unlock; consulte la referencia de la API.