Как управлять питанием ВМ и подключаться к консоли
Команда питания в vStack Center — это не переключатель, а короткая транзакция. vStack Center проверяет права, состояние ВМ, квоты ВЦОД (виртуального центра обработки данных) и overcommit кластера, выбирает узел, ставит блокировку, записывает желаемое состояние и отправляет команду агенту узла. Блокировка снимается, когда приходит ответ агента, — до этого момента другие операции над этой ВМ отбиваются.
С 3.2.0 перед запуском добавлен ещё один шаг: vStack Center спрашивает у узлов, не работает ли машина уже где-то. Раньше решение принималось только по записи в базе центра, и при её расхождении с реальностью команда уходила на второй узел — два гипервизора писали в один диск. Правило опроса такое:
- машина жива на другом узле — запуск отклоняется кодом
-461. Номер узла в сообщение не подставляется намеренно: арендатору не полагается узнавать топологию кластера из текста ошибки, узел уходит в журнал службы; - машина жива на том узле, куда её и запускают, — приходит привычный
-457«уже запущена»; - узлы промолчали, ответили не то или не ответили вовсе — запуск не блокируется. Недоступный узел не должен мешать поднимать машины после сбоя, а это ровно тот сценарий, ради которого запуск и нужен.
Опрос идёт веером сразу всем узлам под общим бюджетом времени (по умолчанию 10 секунд) — на это время ответ на запуск приходит позже. Автоматический подъём машин подчиняется тому же правилу.
Выбор узла — самая содержательная часть запуска. При NVMe-режиме дисков
(nvme = true) диски доступны по сети, поэтому ВМ можно поднять на любом
online-узле: без явно выбранного узла vStack Center сам берёт наименее загруженный. При
virtio-blk (nvme = false) диск виден только узлу, который держит пул, и запуск
где-либо ещё отклоняется.
Консоль устроена иначе: vStack Center ничего не спрашивает у узла. Он читает учётные данные кластера, выдаёт адрес консоли с разовым токеном и перед выдачей сбрасывает предыдущие соединения на этом адресе и порте — новая сессия выбивает прежнюю.
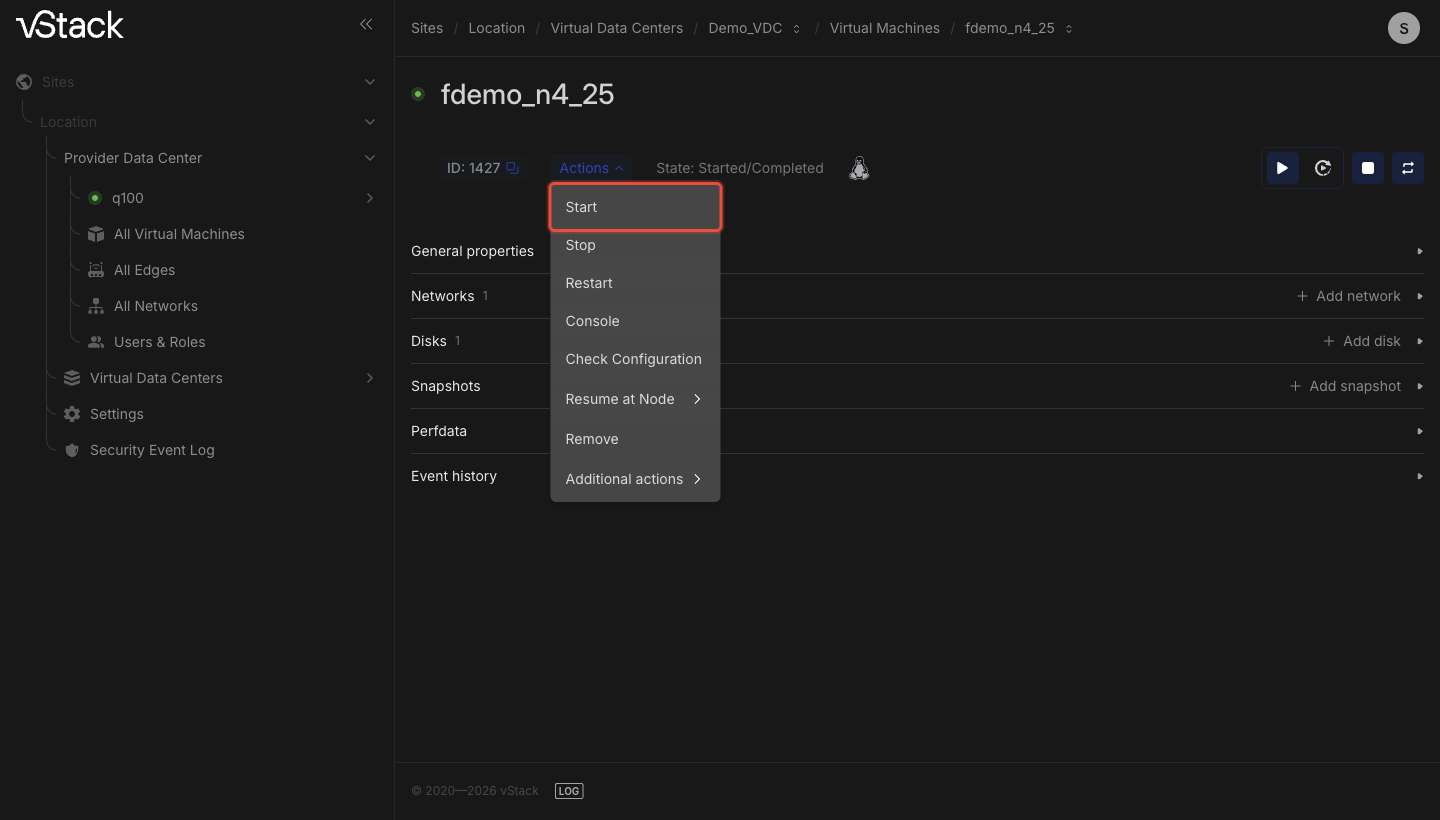
Операции над машиной вызываются кнопкой «Actions» — она есть и на карточке ВМ, и в списке ВМ.
Как запустить ВМ
Доступ: Cluster master — любая ВМ кластера; обычный пользователь — ВМ из ВЦОД,
где у него роль с role_id ≤ 3.
-
Убедитесь, что ВМ остановлена или только что создана: состояние видно в столбце «State» списка ВМ и на карточке машины.
-
Откройте карточку ВМ (или найдите её в списке), нажмите «Actions» и выберите команду запуска.
-
Выберите узел или оставьте автоматический выбор. Дополнительно задаются таймаут жёсткого выключения (0–999 секунд) и отказ от ACPI-выключения; номер узла — от 1 до числа узлов кластера.
-
Дождитесь, пока состояние ВМ сменится на «запущена». Узел, на котором машина поднялась, показан на её карточке — и при явном выборе узла, и при автоматическом.
Если запуск не удался
| Отказ | Почему | Обход |
|---|---|---|
-460 virtio-blk VM: start only on the pool node | У ВМ nvme = false, а выбран узел не из пула | Запускайте на узле пула: оставьте автоматический выбор |
-459 Windows: finish setup on the pool node before remote start | Windows с nvme = true, первичная настройка гостя не закончена | Завершите настройку гостя на узле пула, затем запускайте удалённо |
-458 No available online nodes for VM placement | Нет online-узла под автоматическое размещение | Дождитесь возврата узлов или выберите узел вручную |
-455 VM has suspended status | ВМ приостановлена | Восстановите её из приостановки, а не запускайте |
-457 Unable to start VM having admin_status==N already | ВМ уже запущена — в том числе по докладу того узла, куда её запускают | Проверьте состояние машины на её карточке |
-461 VM is running on another cluster node; unable to start | Узел доложил, что машина работает не там, куда идёт запуск. С 3.2.0 | Найдите, где машина работает, и остановите её там; узел назван в журнале службы |
-409 VM is locked | Идёт другая операция | Дождитесь её завершения; залипшую блокировку снимает роль Cluster master |
-413, -414, -415 | Кончилась квота ВЦОД по хранилищу, RAM или ядрам | Расширьте квоту или освободите ресурсы |
-440 Cluster RAM has been depleted | Кластеру не хватает RAM с учётом overcommit | Освободите память кластера |
-452 Remote disk attach error | При удалённом запуске не подключились NVMe-oF-диски | Запустите на узле пула и проверьте состояние узла |
-442, -443 | Выбран несуществующий узел | Уточните состав кластера |
Как остановить и перезапустить ВМ
Остановка работает симметрично запуску, но без проверки квот: машина уже учтена. vStack Center определяет узел, где ВМ запущена, блокирует её и отправляет команду остановки. Вызывается она так же — «Actions» на карточке ВМ или в списке.
Приостановленную ВМ команда остановки принимает так же, как работающую.
Перезапуск повторяет логику запуска с двумя отличиями: квоты сверяются без добавления ресурсов ВМ, а overcommit — без вычета её RAM из свободной. Узел берётся текущий.
У обеих операций есть таймаут жёсткого выключения и отказ от ACPI. Если гость не реагирует на ACPI, жёсткое выключение по таймауту — штатный путь; отказ от ACPI пропускает попытку корректного завершения сразу.
Что происходит с машиной после аварии
Кроме текущего состояния vStack Center хранит у каждой машины намерение — должна она работать или нет. Запуск ставит намерение «должна работать», остановка администратором его снимает. Автоматический подъём после сбоя возвращает к жизни только машины с намерением «должна работать».
С 3.2.0 центр различает, почему машина выключилась, и снимает намерение только в одном случае — когда гость выключился штатно. При падении гипервизора, перезапуске по просьбе гостя, останове узла и жёстком выключении по таймауту намерение сохраняется, и машина поднимается снова. Раньше любое из этих событий помечало машину остановленной администратором, и после аварии она оставалась выключенной.
Причину выключения присылает агент узла. Агент, выпущенный до vStack OS 3.2.0, её не передаёт — на таких узлах поведение прежнее: после аварии машина считается остановленной, пока агент не обновят.
Подъём запускается событием, а не по таймеру:
- машина упала, а её пул работает, — подъём начинается сразу;
- пул ещё не готов — машина ждёт, пока хранилище поднимется, и стартует вместе с остальными машинами пула;
- первый запуск не удался из-за сбоя на узле — центр повторяет его, не больше трёх раз. Если и они не помогли, повторы прекращаются, но намерение остаётся, и машину попробует поднять следующий проход по любому другому поводу;
- ресурсов на запуск не хватает — машина остаётся с намерением «должна работать», причина пишется в журнал службы, по таймеру запуск не повторяется.
Двойного запуска подъём не вызывает: машину, запуск которой уже идёт, и машину, живую на каком-либо узле, он пропускает — действует то же правило опроса узлов, что и при ручном запуске.
Как приостановить и восстановить ВМ
Приостановка сохраняет состояние памяти и требует включённой возможности
приостановки в настройках кластера. Доступ: Cluster master — полный, остальные —
role_id ≤ 2. Команда вызывается из «Actions»; ВМ переходит в состояние
«приостановлена».
При восстановлении целевой узел задаётся явно. Ограничения по размещению
повторяют запуск: при nvme = false восстановление идёт только на узле пула
(-15152), а Windows с nvme = true до завершения первичной настройки удалённо
не восстанавливается (-15151). Если возможность приостановки выключена в
настройках кластера, приостановка отвечает -15005, а восстановление — -15105.
Массовые операции по пулу
Для обслуживания узла есть парные операции уровня пула: приостановить все ВМ пула и восстановить их обратно. Они доступны только роли Cluster master и вызываются с карточки пула — там тоже есть кнопка «Actions». Дополнительно задаётся возврат машин при ошибке.
Команда идёт напрямую на узел, обслуживающий пул. Отказы: -403 — операцию
вызвала не роль Cluster master (один и тот же код и на приостановке,
и на возобновлении), -15203 и -15303 — неверное имя пула,
-15205 и -15305 — возможность приостановки выключена.
Как открыть консоль
Консоль открывается из «Actions» на карточке ВМ — сразу, без обращения к узлу. Доступ: Cluster master — любая ВМ, обычный пользователь — ВМ из своих ВЦОД.
Консоль бывает двух видов: графическая (VNC) — по умолчанию — и текстовая. У каждого вида свой порт. Если ВМ работает не на узле своего пула, адрес консоли указывает на публичный адрес того узла, где машина запущена.
Что учитывать при работе:
- Ссылка одноразовая по смыслу: каждое открытие консоли сбрасывает предыдущие соединения на том же адресе и порте. Две параллельные консольные сессии к одной ВМ не живут.
- Отказ
-3103означает, что ВМ не найдена в вашей области видимости. - vStack Center не проверяет, запущена ли ВМ: адрес выдаётся из учётных данных кластера. Если подключение не устанавливается, проверьте состояние машины и узла.
Как снять блокировку
Флаг блокировки снимается сам, когда приходит ответ агента. Если агент не ответил и флаг остался, снять его может только роль Cluster master.
Отказ -25903 «VM unlock method available for Cluster master only» означает, что
снятие блокировки запросила другая роль. Снимайте блокировку только после того,
как убедились, что предыдущая операция действительно закончилась: иначе поздний
ответ агента наложится на новую команду.
См. также
- Жизненный цикл виртуальной машины — что означают статусы и почему у ВМ два состояния
- Не открывается VNC-консоль — разбор, если консоль не открывается
Методы API
Операции этой страницы в API: vms-start, vms-stop, vms-restart,
vms-suspend, vms-resume, vms-suspend-pool, vms-resume-pool, vm-console,
vm-unlock — см. Справочник API.